跳到主要内容

3 篇博文 含有标签「Spark」

查看所有标签

· 阅读需 8 分钟

说到数据写入 Elasticsearch,最先想到的肯定是Logstash。Logstash因为其简单上手、可扩展、可伸缩等优点被广大用户接受。但是尺有所短,寸有所长,Logstash肯定也有它无法适用的应用场景,比如:

  • 海量数据ETL
  • 海量数据聚合
  • 多源数据处理

为了满足这些场景,很多同学都会选择Spark,借助Spark算子进行数据处理,最后将处理结果写入Elasticsearch。

我们部门之前利用Spark对Nginx日志进行分析,统计我们的Web服务访问情况,将Nginx日志每分钟聚合一次最后将结果写入Elasticsearch,然后利用Kibana配置实时监控Dashboard。Elasticsearch和Kibana都很方便、实用,但是随着类似需求越来越多,如何快速通过Spark将数据写入Elasticsearch成为了我们的一大问题。

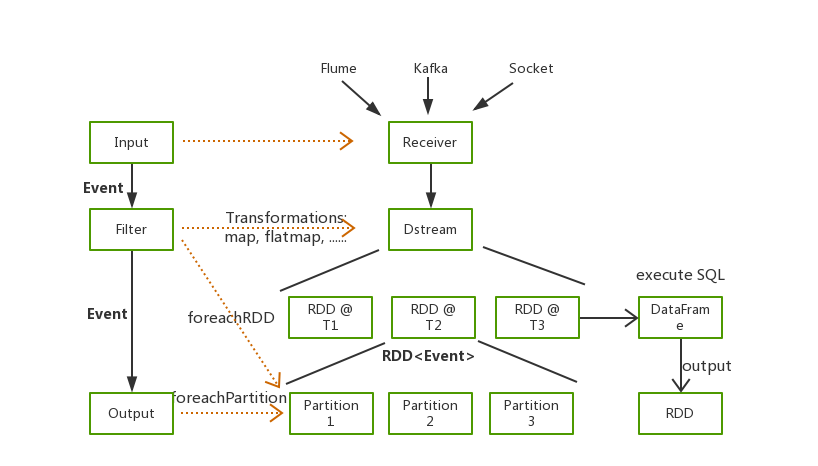
今天给大家推荐一款能够实现数据快速写入的黑科技 Seatunnel https://github.com/apache/incubator-seatunnel 一个非常易用,高性能,能够应对海量数据的实时数据处理产品,它构建在Spark之上,简单易用,灵活配置,无需开发。
Kafka to Elasticsearch​

和Logstash一样,Seatunnel同样支持多种类型的数据输入,这里我们以最常见的Kakfa作为输入源为例,讲解如何使用 Seatunnel 将数据快速写入Elasticsearch

Log Sample​

原始日志格式如下:

127.0.0.1 elasticsearch.cn 114.250.140.241 0.001s "127.0.0.1:80" [26/Oct/2018:21:54:32 +0800] "GET /article HTTP/1.1" 200 123 "-" - "Dalvik/2.1.0 (Linux; U; Android 7.1.1; OPPO R11 Build/NMF26X)"

Elasticsearch Document​

我们想要统计,一分钟每个域名的访问情况,聚合完的数据有以下字段:

domain String
hostname String
status int
datetime String
count int

Seatunnel with Elasticsearch​

接下来会给大家详细介绍,我们如何通过 Seatunnel 读取Kafka中的数据,对数据进行解析以及聚合,最后将处理结果写入Elasticsearch中。

Seatunnel​

Seatunnel 同样拥有着非常丰富的插件,支持从Kafka、HDFS、Hive中读取数据,进行各种各样的数据处理,并将结果写入Elasticsearch、Kudu或者Kafka中。

Prerequisites​

首先我们需要安装seatunnel,安装十分简单,无需配置系统环境变量

  1. 准备Spark环境
  2. 安装 Seatunnel
  3. 配置 Seatunnel

以下是简易步骤,具体安装可以参照 Quick Start

cd /usr/local
wget https://archive.apache.org/dist/spark/spark-2.2.0/spark-2.2.0-bin-hadoop2.7.tgz
tar -xvf https://archive.apache.org/dist/spark/spark-2.2.0/spark-2.2.0-bin-hadoop2.7.tgz
wget https://github.com/InterestingLab/seatunnel/releases/download/v1.1.1/seatunnel-1.1.1.zip
unzip seatunnel-1.1.1.zip
cd seatunnel-1.1.1

vim config/seatunnel-env.sh
# 指定Spark安装路径
SPARK_HOME=${SPARK_HOME:-/usr/local/spark-2.2.0-bin-hadoop2.7}

Seatunnel Pipeline​

与Logstash一样,我们仅需要编写一个Seatunnel Pipeline的配置文件即可完成数据的导入,相信了解Logstash的朋友可以很快入手 Seatunnel 配置。

配置文件包括四个部分,分别是Spark、Input、filter和Output。

Spark​

这一部分是Spark的相关配置,主要配置Spark执行时所需的资源大小。

spark {
spark.app.name = "seatunnel"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
spark.streaming.batchDuration = 5
}

Input​

这一部分定义数据源,如下是从Kafka中读取数据的配置案例,

kafkaStream {
topics = "seatunnel-es"
consumer.bootstrap.servers = "localhost:9092"
consumer.group.id = "seatunnel_es_group"
consumer.rebalance.max.retries = 100
}

Filter​

在Filter部分,这里我们配置一系列的转化,包括正则解析将日志进行拆分、时间转换将HTTPDATE转化为Elasticsearch支持的日期格式、对Number类型的字段进行类型转换以及通过SQL进行数据聚合

filter {
# 使用正则解析原始日志
# 最开始数据都在raw_message字段中
grok {
source_field = "raw_message"
pattern = '%{NOTSPACE:hostname}\\s%{NOTSPACE:domain}\\s%{IP:remote_addr}\\s%{NUMBER:request_time}s\\s\"%{DATA:upstream_ip}\"\\s\\[%{HTTPDATE:timestamp}\\]\\s\"%{NOTSPACE:method}\\s%{DATA:url}\\s%{NOTSPACE:http_ver}\"\\s%{NUMBER:status}\\s%{NUMBER:body_bytes_send}\\s%{DATA:referer}\\s%{NOTSPACE:cookie_info}\\s\"%{DATA:user_agent}'
}
# 将"dd/MMM/yyyy:HH:mm:ss Z"格式的数据转换为
# Elasticsearch中支持的格式
date {
source_field = "timestamp"
target_field = "datetime"
source_time_format = "dd/MMM/yyyy:HH:mm:ss Z"
target_time_format = "yyyy-MM-dd'T'HH:mm:ss.SSS+08:00"
}
## 利用SQL对数据进行聚合
sql {
table_name = "access_log"
sql = "select domain, hostname, int(status), datetime, count(*) from access_log group by domain, hostname, status, datetime"
}
}

Output​

最后我们将处理好的结构化数据写入Elasticsearch。

output {
elasticsearch {
hosts = ["localhost:9200"]
index = "seatunnel-${now}"
es.batch.size.entries = 100000
index_time_format = "yyyy.MM.dd"
}
}

Running Seatunnel​

我们将上述四部分配置组合成为我们的配置文件 config/batch.conf。

vim config/batch.conf
spark {
spark.app.name = "seatunnel"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
spark.streaming.batchDuration = 5
}
input {
kafkaStream {
topics = "seatunnel-es"
consumer.bootstrap.servers = "localhost:9092"
consumer.group.id = "seatunnel_es_group"
consumer.rebalance.max.retries = 100
}
}
filter {
# 使用正则解析原始日志
# 最开始数据都在raw_message字段中
grok {
source_field = "raw_message"
pattern = '%{IP:hostname}\\s%{NOTSPACE:domain}\\s%{IP:remote_addr}\\s%{NUMBER:request_time}s\\s\"%{DATA:upstream_ip}\"\\s\\[%{HTTPDATE:timestamp}\\]\\s\"%{NOTSPACE:method}\\s%{DATA:url}\\s%{NOTSPACE:http_ver}\"\\s%{NUMBER:status}\\s%{NUMBER:body_bytes_send}\\s%{DATA:referer}\\s%{NOTSPACE:cookie_info}\\s\"%{DATA:user_agent}'
}
# 将"dd/MMM/yyyy:HH:mm:ss Z"格式的数据转换为
# Elasticsearch中支持的格式
date {
source_field = "timestamp"
target_field = "datetime"
source_time_format = "dd/MMM/yyyy:HH:mm:ss Z"
target_time_format = "yyyy-MM-dd'T'HH:mm:00.SSS+08:00"
}
## 利用SQL对数据进行聚合
sql {
table_name = "access_log"
sql = "select domain, hostname, status, datetime, count(*) from access_log group by domain, hostname, status, datetime"
}
}
output {
elasticsearch {
hosts = ["localhost:9200"]
index = "seatunnel-${now}"
es.batch.size.entries = 100000
index_time_format = "yyyy.MM.dd"
}
}

执行命令,指定配置文件,运行 Seatunnel,即可将数据写入Elasticsearch。这里我们以本地模式为例。

./bin/start-seatunnel.sh --config config/batch.conf -e client -m 'local[2]'

最后,写入Elasticsearch中的数据如下,再配上Kibana就可以实现Web服务的实时监控了^_^.

"_source": {
"domain": "elasticsearch.cn",
"hostname": "localhost",
"status": "200",
"datetime": "2018-11-26T21:54:00.000+08:00",
"count": 26
}

Conclusion​

在这篇文章中,我们介绍了如何通过 Seatunnel 将Kafka中的数据写入Elasticsearch中。仅仅通过一个配置文件便可快速运行一个Spark Application,完成数据的处理、写入,无需编写任何代码,十分简单。

当数据处理过程中有遇到Logstash无法支持的场景或者Logstah性能无法达到预期的情况下,都可以尝试使用 Seatunnel 解决问题。

希望了解 Seatunnel 与Elasticsearch、Kafka、Hadoop结合使用的更多功能和案例,可以直接进入官网 https://seatunnel.apache.org/

我们近期会再发布一篇《如何用Spark和Elasticsearch做交互式数据分析》,敬请期待.

Contract us​

  • 邮件列表 : dev@seatunnel.apache.org. 发送任意内容至 dev-subscribe@seatunnel.apache.org, 按照回复订阅邮件列表。
  • Slack: 发送 Request to join SeaTunnel slack 邮件到邮件列表 (dev@seatunnel.apache.org), 我们会邀请你加入(在此之前请确认已经注册Slack).
  • bilibili B站 视频

· 阅读需 9 分钟

TiDB 是一款定位于在线事务处理/在线分析处理的融合型数据库产品,实现了一键水平伸缩,强一致性的多副本数据安全,分布式事务,实时 OLAP 等重要特性。

TiSpark 是 PingCAP 为解决用户复杂 OLAP 需求而推出的产品。它借助 Spark 平台,同时融合 TiKV 分布式集群的优势。

直接使用 TiSpark 完成 OLAP 操作需要了解 Spark,还需要一些开发工作。那么,有没有一些开箱即用的工具能帮我们更快速地使用 TiSpark 在 TiDB 上完成 OLAP 分析呢?

目前开源社区上有一款工具 Seatunnel,项目地址 https://github.com/apache/incubator-seatunnel ,可以基于Spark,在 TiSpark 的基础上快速实现 TiDB 数据读取和 OLAP 分析。

使用 Seatunnel 操作TiDB​

在我们线上有这么一个需求,从 TiDB 中读取某一天的网站访问数据,统计每个域名以及服务返回状态码的访问次数,最后将统计结果写入 TiDB 另外一个表中。 我们来看看 Seatunnel 是如何实现这么一个功能的。

Seatunnel​

Seatunnel 是一个非常易用,高性能,能够应对海量数据的实时数据处理产品,它构建在 Spark 之上。Seatunnel 拥有着非常丰富的插件,支持从 TiDB、Kafka、HDFS、Kudu 中读取数据,进行各种各样的数据处理,然后将结果写入 TiDB、ClickHouse、Elasticsearch 或者 Kafka 中。

准备工作​

1. TiDB 表结构介绍​

Input(存储访问日志的表)

CREATE TABLE access_log (
domain VARCHAR(255),
datetime VARCHAR(63),
remote_addr VARCHAR(63),
http_ver VARCHAR(15),
body_bytes_send INT,
status INT,
request_time FLOAT,
url TEXT
)
+-----------------+--------------+------+------+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-----------------+--------------+------+------+---------+-------+
| domain | varchar(255) | YES | | NULL | |
| datetime | varchar(63) | YES | | NULL | |
| remote_addr | varchar(63) | YES | | NULL | |
| http_ver | varchar(15) | YES | | NULL | |
| body_bytes_send | int(11) | YES | | NULL | |
| status | int(11) | YES | | NULL | |
| request_time | float | YES | | NULL | |
| url | text | YES | | NULL | |
+-----------------+--------------+------+------+---------+-------+

Output(存储结果数据的表)

CREATE TABLE access_collect (
date VARCHAR(23),
domain VARCHAR(63),
status INT,
hit INT
)
+--------+-------------+------+------+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+--------+-------------+------+------+---------+-------+
| date | varchar(23) | YES | | NULL | |
| domain | varchar(63) | YES | | NULL | |
| status | int(11) | YES | | NULL | |
| hit | int(11) | YES | | NULL | |
+--------+-------------+------+------+---------+-------+
2. 安装 Seatunnel​

有了 TiDB 输入和输出表之后, 我们需要安装 Seatunnel,安装十分简单,无需配置系统环境变量

  1. 准备 Spark环境
  2. 安装 Seatunnel
  3. 配置 Seatunnel

以下是简易步骤,具体安装可以参照 Quick Start

# 下载安装Spark
cd /usr/local
wget https://archive.apache.org/dist/spark/spark-2.1.0/spark-2.1.0-bin-hadoop2.7.tgz
tar -xvf https://archive.apache.org/dist/spark/spark-2.1.0/spark-2.1.0-bin-hadoop2.7.tgz
wget
# 下载安装seatunnel
https://github.com/InterestingLab/seatunnel/releases/download/v1.2.0/seatunnel-1.2.0.zip
unzip seatunnel-1.2.0.zip
cd seatunnel-1.2.0

vim config/seatunnel-env.sh
# 指定Spark安装路径
SPARK_HOME=${SPARK_HOME:-/usr/local/spark-2.1.0-bin-hadoop2.7}

实现 Seatunnel 处理流程​

我们仅需要编写一个 Seatunnel 配置文件即可完成数据的读取、处理、写入。

Seatunnel 配置文件由四个部分组成,分别是 Spark、Input、Filter 和 Output。Input 部分用于指定数据的输入源,Filter 部分用于定义各种各样的数据处理、聚合,Output 部分负责将处理之后的数据写入指定的数据库或者消息队列。

整个处理流程为 Input -> Filter -> Output,整个流程组成了 Seatunnel 的 处理流程(Pipeline)。

以下是一个具体配置,此配置来源于线上实际应用,但是为了演示有所简化。

Input (TiDB)​

这里部分配置定义输入源,如下是从 TiDB 一张表中读取数据。

input {
tidb {
database = "nginx"
pre_sql = "select * from nginx.access_log"
table_name = "spark_nginx_input"
}
}
Filter​

在Filter部分,这里我们配置一系列的转化, 大部分数据分析的需求,都是在Filter完成的。Seatunnel 提供了丰富的插件,足以满足各种数据分析需求。这里我们通过 SQL 插件完成数据的聚合操作。

filter {
sql {
table_name = "spark_nginx_log"
sql = "select count(*) as hit, domain, status, substring(datetime, 1, 10) as date from spark_nginx_log where substring(datetime, 1, 10)='2019-01-20' group by domain, status, substring(datetime, 1, 10)"
}
}
Output (TiDB)​

最后, 我们将处理后的结果写入TiDB另外一张表中。TiDB Output是通过JDBC实现的

output {
tidb {
url = "jdbc:mysql://127.0.0.1:4000/nginx?useUnicode=true&characterEncoding=utf8"
table = "access_collect"
user = "username"
password = "password"
save_mode = "append"
}
}
Spark​

这一部分是 Spark 的相关配置,主要配置 Spark 执行时所需的资源大小以及其他 Spark 配置。

我们的 TiDB Input 插件是基于 TiSpark 实现的,而 TiSpark 依赖于 TiKV 集群和 Placement Driver (PD)。因此我们需要指定 PD 节点信息以及 TiSpark 相关配置spark.tispark.pd.addresses和spark.sql.extensions。

spark {
spark.app.name = "seatunnel-tidb"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
# Set for TiSpark
spark.tispark.pd.addresses = "localhost:2379"
spark.sql.extensions = "org.apache.spark.sql.TiExtensions"
}

运行 Seatunnel​

我们将上述四部分配置组合成我们最终的配置文件 conf/tidb.conf

spark {
spark.app.name = "seatunnel-tidb"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
# Set for TiSpark
spark.tispark.pd.addresses = "localhost:2379"
spark.sql.extensions = "org.apache.spark.sql.TiExtensions"
}
input {
tidb {
database = "nginx"
pre_sql = "select * from nginx.access_log"
table_name = "spark_table"
}
}
filter {
sql {
table_name = "spark_nginx_log"
sql = "select count(*) as hit, domain, status, substring(datetime, 1, 10) as date from spark_nginx_log where substring(datetime, 1, 10)='2019-01-20' group by domain, status, substring(datetime, 1, 10)"
}
}
output {
tidb {
url = "jdbc:mysql://127.0.0.1:4000/nginx?useUnicode=true&characterEncoding=utf8"
table = "access_collect"
user = "username"
password = "password"
save_mode = "append"
}
}

执行命令,指定配置文件,运行 Seatunnel ,即可实现我们的数据处理逻辑。

  • Local

./bin/start-seatunnel.sh --config config/tidb.conf --deploy-mode client --master 'local[2]'

  • yarn-client

./bin/start-seatunnel.sh --config config/tidb.conf --deploy-mode client --master yarn

  • yarn-cluster

./bin/start-seatunnel.sh --config config/tidb.conf --deploy-mode cluster -master yarn

如果是本机测试验证逻辑,用本地模式(Local)就可以了,一般生产环境下,都是使用yarn-client或者yarn-cluster模式。

检查结果​

mysql> select * from access_collect;
+------------+--------+--------+------+
| date | domain | status | hit |
+------------+--------+--------+------+
| 2019-01-20 | b.com | 200 | 63 |
| 2019-01-20 | a.com | 200 | 85 |
+------------+--------+--------+------+
2 rows in set (0.21 sec)

总结​

在这篇文章中,我们介绍了如何使用 Seatunnel 从 TiDB 中读取数据,做简单的数据处理之后写入 TiDB 另外一个表中。仅通过一个配置文件便可快速完成数据的导入,无需编写任何代码。

除了支持 TiDB 数据源之外,Seatunnel 同样支持Elasticsearch, Kafka, Kudu, ClickHouse等数据源。

于此同时,我们正在研发一个重要功能,就是在 Seatunnel 中,利用 TiDB 的事务特性,实现从 Kafka 到 TiDB 流式数据处理,并且支持端(Kafka)到端(TiDB)的 Exactly-Once 数据一致性。

希望了解 Seatunnel 和 TiDB,ClickHouse、Elasticsearch、Kafka结合使用的更多功能和案例,可以直接进入官网 https://seatunnel.apache.org/

联系我们​

  • 邮件列表 : dev@seatunnel.apache.org. 发送任意内容至 dev-subscribe@seatunnel.apache.org, 按照回复订阅邮件列表。
  • Slack: 发送 Request to join SeaTunnel slack 邮件到邮件列表 (dev@seatunnel.apache.org), 我们会邀请你加入(在此之前请确认已经注册Slack).
  • bilibili B站 视频

-- Power by InterestingLab

· 阅读需 11 分钟

前言​

StructuredStreaming是Spark 2.0以后新开放的一个模块,相比SparkStreaming,它有一些比较突出的优点:
  一、它能做到更低的延迟;
  二、可以做实时的聚合,例如实时计算每天每个商品的销售总额;
  三、可以做流与流之间的关联,例如计算广告的点击率,需要将广告的曝光记录和点击记录关联。
以上几点如果使用SparkStreaming来实现可能会比较麻烦或者说是很难实现,但是使用StructuredStreaming实现起来会比较轻松。

如何使用StructuredStreaming​

可能你没有详细研究过StructuredStreaming,但是发现StructuredStreaming能很好的解决你的需求,如何快速利用StructuredStreaming来解决你的需求?目前社区有一款工具 Seatunnel,项目地址:https://github.com/apache/incubator-seatunnel , 可以高效低成本的帮助你利用StructuredStreaming来完成你的需求。

Seatunnel​

Seatunnel 是一个非常易用,高性能,能够应对海量数据的实时数据处理产品,它构建在Spark之上。Seatunnel 拥有着非常丰富的插件,支持从Kafka、HDFS、Kudu中读取数据,进行各种各样的数据处理,并将结果写入ClickHouse、Elasticsearch或者Kafka中

准备工作​

首先我们需要安装 Seatunnel,安装十分简单,无需配置系统环境变量

  1. 准备Spark环境
  2. 安装 Seatunnel
  3. 配置 Seatunnel

以下是简易步骤,具体安装可以参照 Quick Start

cd /usr/local
wget https://archive.apache.org/dist/spark/spark-2.2.0/spark-2.2.0-bin-hadoop2.7.tgz
tar -xvf https://archive.apache.org/dist/spark/spark-2.2.0/spark-2.2.0-bin-hadoop2.7.tgz
wget https://github.com/InterestingLab/seatunnel/releases/download/v1.3.0/seatunnel-1.3.0.zip
unzip seatunnel-1.3.0.zip
cd seatunnel-1.3.0

vim config/seatunnel-env.sh
# 指定Spark安装路径
SPARK_HOME=${SPARK_HOME:-/usr/local/spark-2.2.0-bin-hadoop2.7}

Seatunnel Pipeline​

我们仅需要编写一个 Seatunnel Pipeline的配置文件即可完成数据的导入。

配置文件包括四个部分,分别是Spark、Input、filter和Output。

Spark​

这一部分是Spark的相关配置,主要配置Spark执行时所需的资源大小。

spark {
spark.app.name = "seatunnel"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
}

Input​

下面是一个从kafka读取数据的例子

kafkaStream {
topics = "seatunnel"
consumer.bootstrap.servers = "localhost:9092"
schema = "{\"name\":\"string\",\"age\":\"integer\",\"addrs\":{\"country\":\"string\",\"city\":\"string\"}}"
}

通过上面的配置就可以读取kafka里的数据了 ,topics是要订阅的kafka的topic,同时订阅多个topic可以以逗号隔开,consumer.bootstrap.servers就是Kafka的服务器列表,schema是可选项,因为StructuredStreaming从kafka读取到的值(官方固定字段value)是binary类型的,详见http://spark.apache.org/docs/latest/structured-streaming-kafka-integration.html 但是如果你确定你kafka里的数据是json字符串的话,你可以指定schema,input插件将按照你指定的schema解析

Filter​

下面是一个简单的filter例子

filter{
sql{
table_name = "student"
sql = "select name,age from student"
}
}

table_name是注册成的临时表名,以便于在下面的sql使用

Output​

处理好的数据往外输出,假设我们的输出也是kafka

output{
kafka {
topic = "seatunnel"
producer.bootstrap.servers = "localhost:9092"
streaming_output_mode = "update"
checkpointLocation = "/your/path"
}
}

topic 是你要输出的topic, producer.bootstrap.servers是kafka集群列表,streaming_output_mode是StructuredStreaming的一个输出模式参数,有三种类型append|update|complete,具体使用参见文档http://spark.apache.org/docs/latest/structured-streaming-programming-guide.html#output-modes

checkpointLocation是StructuredStreaming的checkpoint路径,如果配置了的话,这个目录会存储程序的运行信息,比如程序退出再启动的话会接着上次的offset进行消费。

场景分析​

以上就是一个简单的例子,接下来我们就来介绍的稍微复杂一些的业务场景

场景一:实时聚合场景​

假设现在有一个商城,上面有10种商品,现在需要实时求每天每种商品的销售额,甚至是求每种商品的购买人数(不要求十分精确)。 这么做的巨大的优势就是海量数据可以在实时处理的时候,完成聚合,再也不需要先将数据写入数据仓库,再跑离线的定时任务进行聚合, 操作起来还是很方便的。

kafka的数据如下

{"good_id":"abc","price":300,"user_id":123456,"time":1553216320}

那我们该怎么利用 Seatunnel 来完成这个需求呢,当然还是只需要配置就好了。

#spark里的配置根据业务需求配置
spark {
spark.app.name = "seatunnel"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
}

#配置input
input {
kafkaStream {
topics = "good_topic"
consumer.bootstrap.servers = "localhost:9092"
schema = "{\"good_id\":\"string\",\"price\":\"integer\",\"user_id\":\"Long\",\"time\":\"Long\"}"
}
}

#配置filter
filter {

#在程序做聚合的时候,内部会去存储程序从启动开始的聚合状态,久而久之会导致OOM,如果设置了watermark,程序自动的会去清理watermark之外的状态
#这里表示使用ts字段设置watermark,界限为1天

Watermark {
time_field = "time"
time_type = "UNIX" #UNIX表示时间字段为10为的时间戳,还有其他的类型详细可以查看插件文档
time_pattern = "yyyy-MM-dd" #这里之所以要把ts对其到天是因为求每天的销售额,如果是求每小时的销售额可以对其到小时`yyyy-MM-dd HH`
delay_threshold = "1 day"
watermark_field = "ts" #设置watermark之后会新增一个字段,`ts`就是这个字段的名字
}

#之所以要group by ts是要让watermark生效,approx_count_distinct是一个估值,并不是精确的count_distinct
sql {
table_name = "good_table_2"
sql = "select good_id,sum(price) total, approx_count_distinct(user_id) person from good_table_2 group by ts,good_id"
}
}

#接下来我们选择将结果实时输出到Kafka
output{
kafka {
topic = "seatunnel"
producer.bootstrap.servers = "localhost:9092"
streaming_output_mode = "update"
checkpointLocation = "/your/path"
}
}

如上配置完成,启动 Seatunnel,就可以获取你想要的结果了。

场景二:多个流关联场景​

假设你在某个平台投放了广告,现在要实时计算出每个广告的CTR(点击率),数据分别来自两个topic,一个是广告曝光日志,一个是广告点击日志, 此时我们就需要把两个流数据关联到一起做计算,而 Seatunnel 最近也支持了此功能,让我们一起看一下该怎么做:

点击topic数据格式

{"ad_id":"abc","click_time":1553216320,"user_id":12345}

曝光topic数据格式

{"ad_id":"abc","show_time":1553216220,"user_id":12345}

#spark里的配置根据业务需求配置
spark {
spark.app.name = "seatunnel"
spark.executor.instances = 2
spark.executor.cores = 1
spark.executor.memory = "1g"
}

#配置input
input {

kafkaStream {
topics = "click_topic"
consumer.bootstrap.servers = "localhost:9092"
schema = "{\"ad_id\":\"string\",\"user_id\":\"Long\",\"click_time\":\"Long\"}"
table_name = "click_table"
}

kafkaStream {
topics = "show_topic"
consumer.bootstrap.servers = "localhost:9092"
schema = "{\"ad_id\":\"string\",\"user_id\":\"Long\",\"show_time\":\"Long\"}"
table_name = "show_table"
}
}

filter {

#左关联右表必须设置watermark
#右关左右表必须设置watermark
#http://spark.apache.org/docs/latest/structured-streaming-programming-guide.html#inner-joins-with-optional-watermarking
Watermark {
source_table_name = "click_table" #这里可以指定为某个临时表添加watermark,不指定的话就是为input中的第一个
time_field = "time"
time_type = "UNIX"
delay_threshold = "3 hours"
watermark_field = "ts"
result_table_name = "click_table_watermark" #添加完watermark之后可以注册成临时表,方便后续在sql中使用
}

Watermark {
source_table_name = "show_table"
time_field = "time"
time_type = "UNIX"
delay_threshold = "2 hours"
watermark_field = "ts"
result_table_name = "show_table_watermark"
}


sql {
table_name = "show_table_watermark"
sql = "select a.ad_id,count(b.user_id)/count(a.user_id) ctr from show_table_watermark as a left join click_table_watermark as b on a.ad_id = b.ad_id and a.user_id = b.user_id "
}

}

#接下来我们选择将结果实时输出到Kafka
output {
kafka {
topic = "seatunnel"
producer.bootstrap.servers = "localhost:9092"
streaming_output_mode = "append" #流关联只支持append模式
checkpointLocation = "/your/path"
}
}

通过配置,到这里流关联的案例也完成了。

结语​

通过配置能很快的利用StructuredStreaming做实时数据处理,但是还是需要对StructuredStreaming的一些概念了解,比如其中的watermark机制,还有程序的输出模式。

最后,Seatunnel 当然还支持spark streaming和spark 批处理。 如果你对这两个也感兴趣的话,可以阅读我们以前发布的文章《如何快速地将Hive中的数据导入ClickHouse》、 《优秀的数据工程师,怎么用Spark在TiDB上做OLAP分析》、 《如何使用Spark快速将数据写入Elasticsearch》

希望了解 Seatunnel 和 HBase, ClickHouse、Elasticsearch、Kafka、MySQL 等数据源结合使用的更多功能和案例,可以直接进入官网 https://seatunnel.apache.org/

联系我们​

  • 邮件列表 : dev@seatunnel.apache.org. 发送任意内容至 dev-subscribe@seatunnel.apache.org, 按照回复订阅邮件列表。
  • Slack: 发送 Request to join SeaTunnel slack 邮件到邮件列表 (dev@seatunnel.apache.org), 我们会邀请你加入(在此之前请确认已经注册Slack).
  • bilibili B站 视频